SEO 調研用 Claude MCP 工具伺服器,帶單次呼叫預算限制
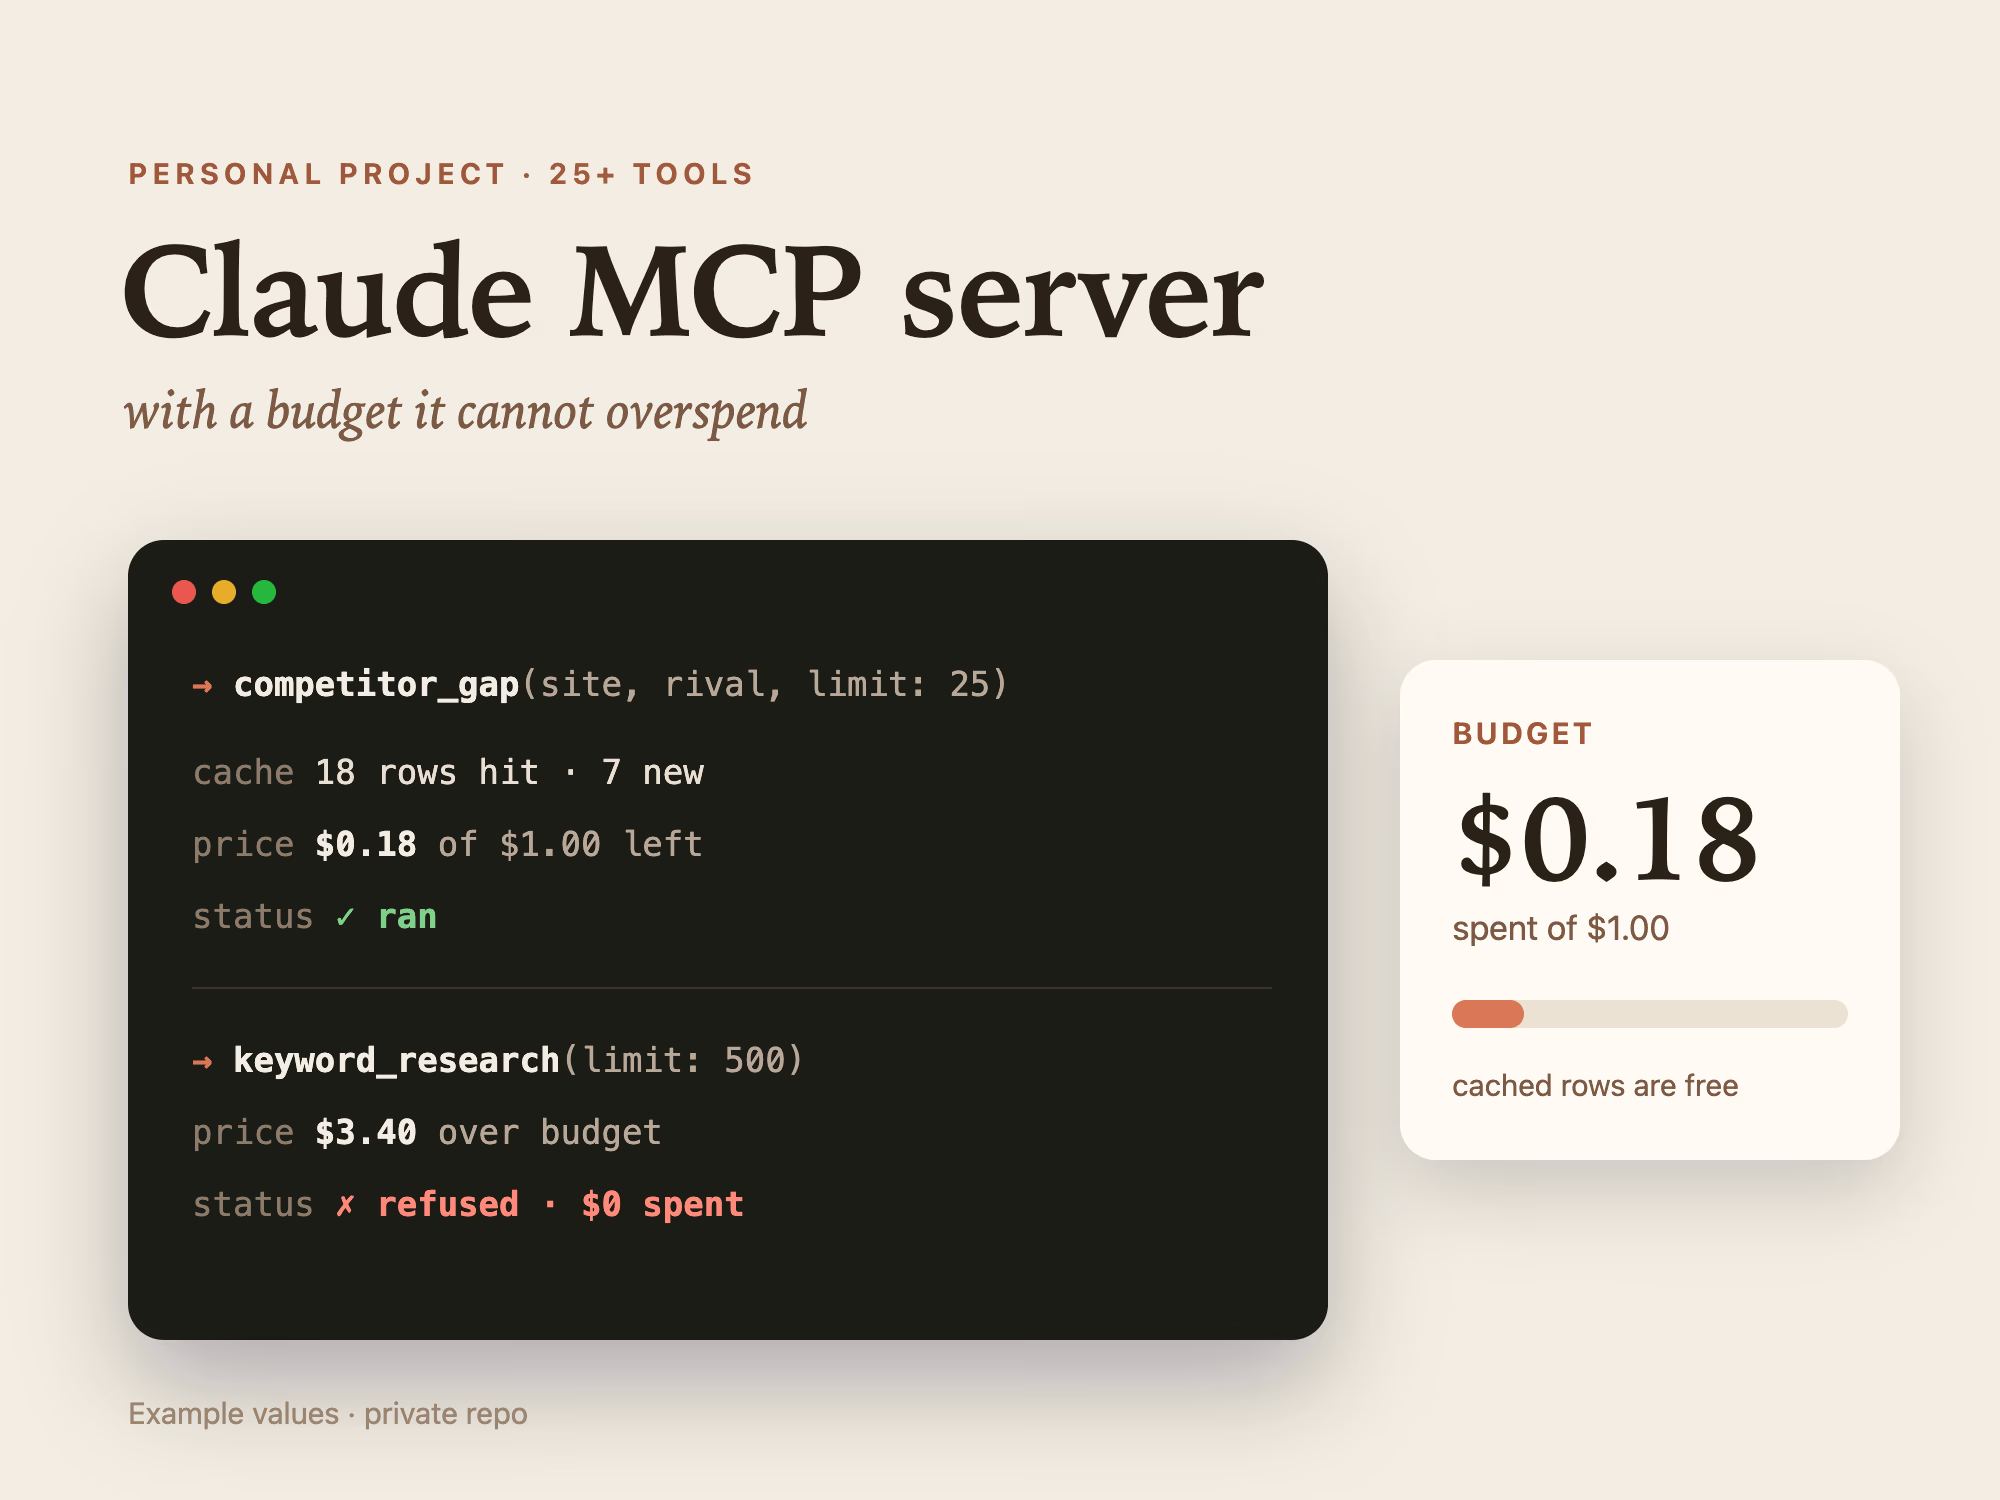
一個私有 MCP 伺服器,讓 Claude 能呼叫 25+ 個付費 SEO / 數據分析工具 —— 每次付費呼叫先估價,超預算直接拒絕並回傳預估,不會做到一半才停;查詢有重疊時只為新增部分付費。
 TypeScript
 Cloudflare個人專案AI
概述
付費 SEO 資料 API 是按次計費的,AI agent 一旦放開呼叫,帳單會漲得很快。我做了一個私有 MCP 伺服器,讓 Claude 能用 25+ 個工具做關鍵詞和 SERP 調研、競品分析、反向連結、AI 搜尋可見度、Search Console 和站點資料分析——成本控制是寫在協定層裡的,不是事後補上去的。每次付費呼叫在執行前先估價;超出預算就直接拒絕並回傳預估,絕不會執行到一半才被中斷。快取按單條資料存,查詢和之前有重疊時只為新增的部分付費。上游出錯時回傳明確的錯誤類型,不是籠統的 500。我自己用它做站點的 SEO 調研和排名追蹤。個人專案,非付費客戶專案;私有儲存庫。
問題:開放呼叫,帳單無底洞
付費 SEO 服務商提供的關鍵詞、SERP、競品和反向連結資料都是按次計費的。給 AI agent 開放呼叫這類 API,它會很樂意為了把一個問題答透而反覆呼叫——這正是帳單失控的典型路徑。我希望 Claude 能自由地用這些工具為我自己做 SEO 調研,但單次會話能花多少錢要有硬上限,而且這個上限要在呼叫真正發生的地方強制生效,不能指望模型自己把握。
25+ 個工具,一道預算閘門
這個伺服器向 Claude 暴露 25+ 個工具:關鍵詞和 SERP 調研、競品分析、反向連結、AI 搜尋可見度追蹤、Search Console 資料和通用站點分析。每一個會打到付費上游 API 的工具都先過同一道閘門:估算這次具體呼叫要花多少錢,和會話預算的剩餘額度比較,通過了才真正執行。如果預估超出剩餘預算,呼叫會被直接拒絕,回傳的是預估金額——由 Claude(或者我)來決定這筆錢花得值不值,而不是等事後才發現花了多少。
快取只為新資料付費,不為重複提問付費
結果按單條資料快取,而不是按整次查詢快取。當一個新查詢和之前跑過的某次有部分重疊,伺服器只為缺的那部分資料向上游付費——重疊的部分直接從快取免費回傳。結合預算閘門,這意味著 Claude 為了真正調研一個主題所需要的那種反覆試探式提問,不會每次細化問題就把成本再乘一遍。
類型化錯誤,不是籠統的 500
當上游服務出錯時——限流、配額用盡、回應格式異常、逾時——伺服器會回傳一個類型化的錯誤,而不是讓它坍縮成一個籠統的失敗。這對 AI 客戶端和對人一樣重要:Claude 能分辨出「稍後重試」和「這個查詢本身就不合法」的區別,並據此採取不同的動作,而不是只能回報「出錯了」。
技術棧
TypeScript,部署在 Cloudflare Workers 上。